你手上有一本喜歡的小說,想把它拍成一集一集的短劇。最直覺的做法,是把劇情丟給影片生成模型,期待它自己演出來。
但長篇故事最難的往往不是「讓畫面動」,而是讓同一個人撐過十集不換臉,讓沒讀過原著的觀眾也看得懂。這篇用我做完的十集《金瓶梅》短劇,整理出一套非影視本科也能照著走的做法。
- 不一定要用影片生成:十集全是生成的靜態圖,靠旁白、字幕與剪輯撐起來,第八到第十集新增的付費費用是 US$0。
- 順序是原典 → 聲音 → 分鏡:先鎖取材範圍與敏感邊界,配音定稿後才畫圖,畫面跟著聲音走。
- 找沒讀過原著的人看第一版:一句「我有點看不懂」,比所有自動檢查都更早發現問題。
- 機器說通過,不等於人核准:臉、讀音、道具數量,都要有人實際看過、聽過。
素材是公共領域的《金瓶梅詞話》(萬曆本),全文收錄在站上的原文書房;十集成片、選角與角色參考圖組,都在金瓶梅影像工作室。
先問:畫面真的需要動嗎?
這套短劇從第一天就定好格式:生成的靜態圖片+配音+剪輯,完全不用影片生成模型。十集片長從 3 分多鐘到將近 8 分鐘,合計約 54 分鐘。
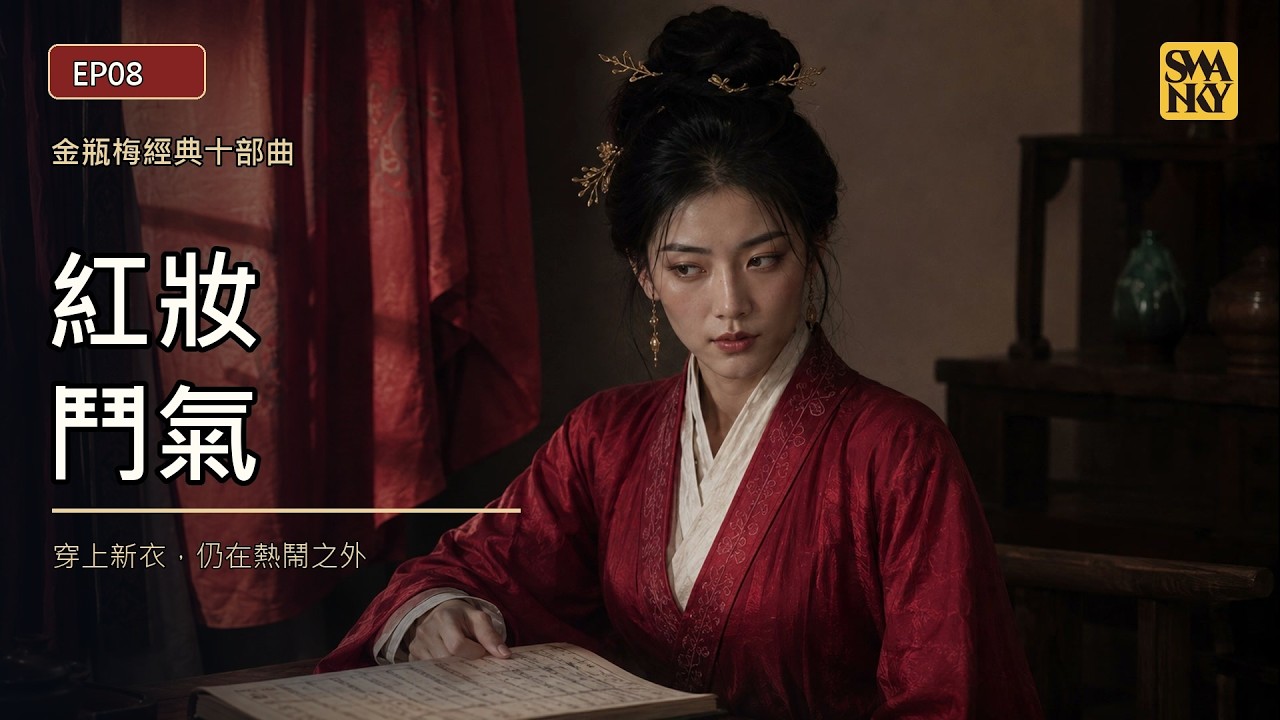
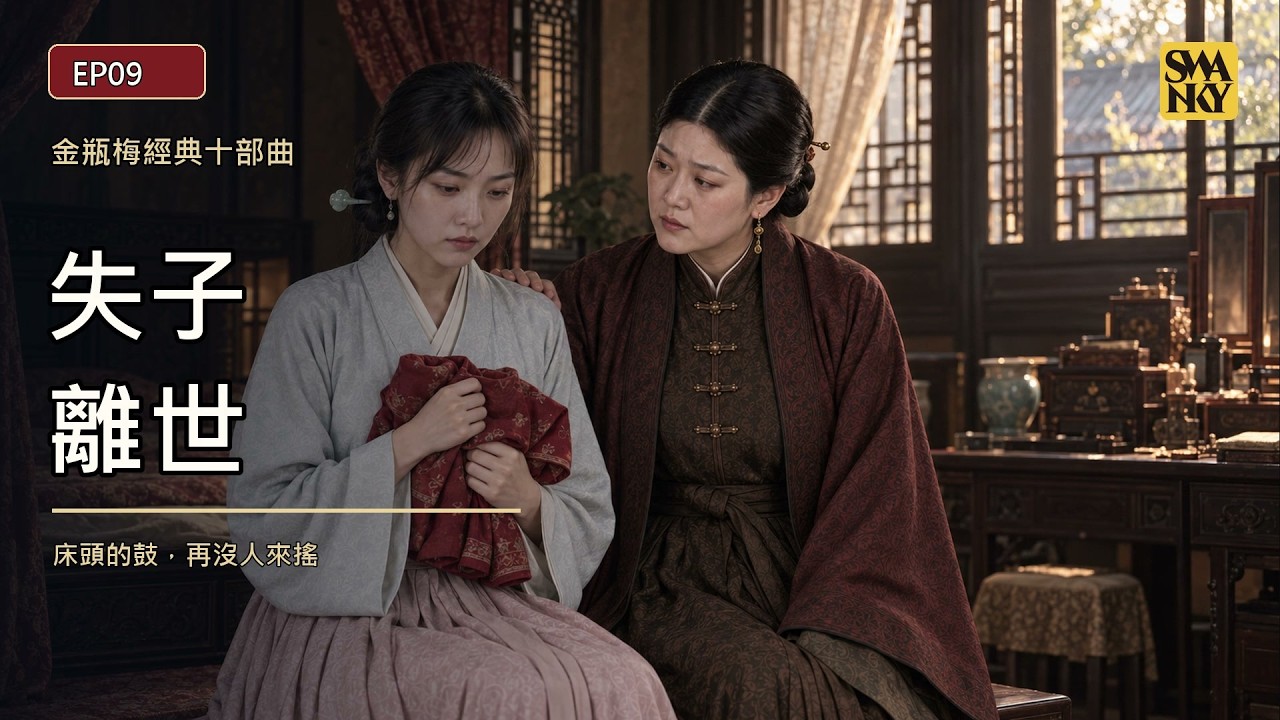
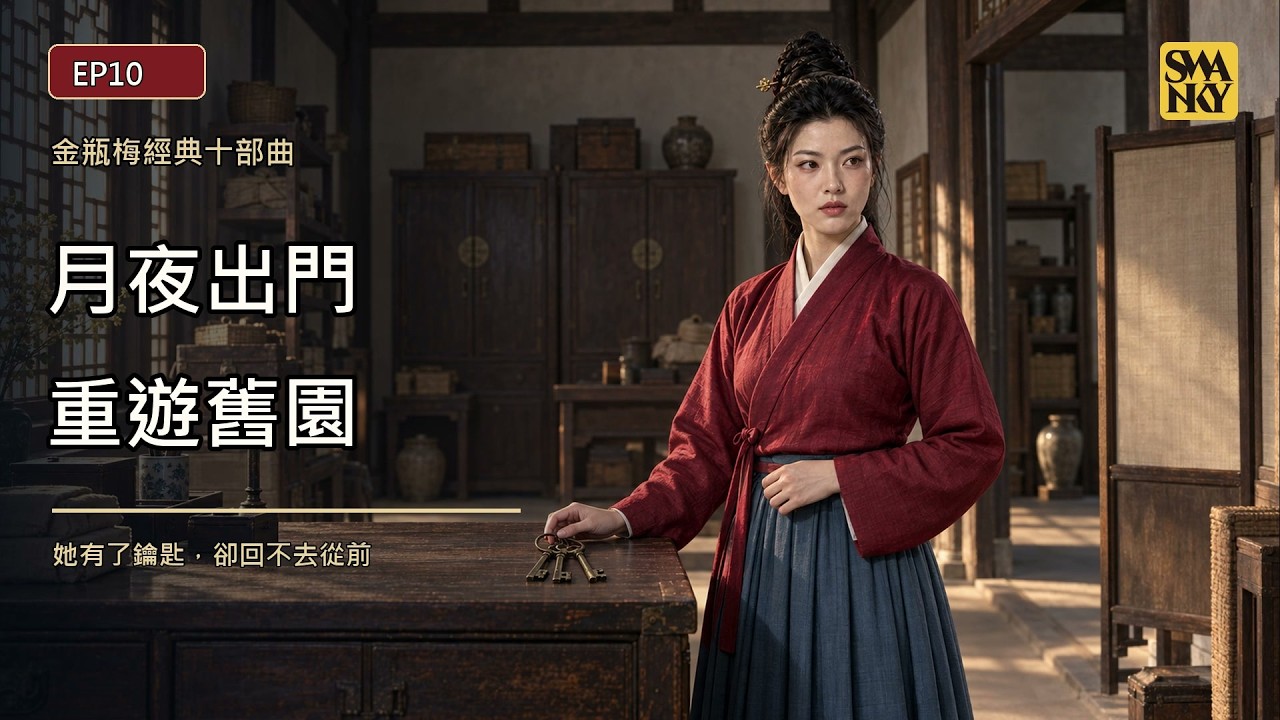
我選靜態圖,是因為長篇古裝故事要的東西跟動作片不一樣:
- 人物要撐十集不換臉。每生成一次,臉就可能跑掉;靜態圖可以一張一張放大檢查,不合格就退件。
- 劇情靠對白與心事推進。多數畫面只要「讀得懂的一瞬間」,不需要角色真的走路、倒水。
- 成本壓得很低。第八到第十集,圖片用 ChatGPT 訂閱裡的生圖額度,配音用免費的語音合成服務,新增的付費費用是 US$0。
下面哪一種故事,最適合先試「靜態圖+旁白」?
- A、C:賣點就是動作本身。這篇的做法是為對白與心事設計的,不用 AI 變形假裝角色走路或倒下。
看答案
靜態圖也不能一張撐到底。我給自己的規則是:
- 不用 AI 變形假裝角色走路、接吻或倒下,也不要每張圖都慢慢放大(看三張就膩了)。
- 運鏡要有理由:緩推=人物意識到真相,緩拉=她被空間包圍。
- 同一構圖做第二張狀態圖,只改一件事,例如「手握簪/簪落地」,用剪接代替生成動作。
- 每 6 到 10 秒,至少要有一個聲音或畫面的變化。一張圖硬撐 20 秒,就是在消耗觀眾。
十道關卡,兩條規則
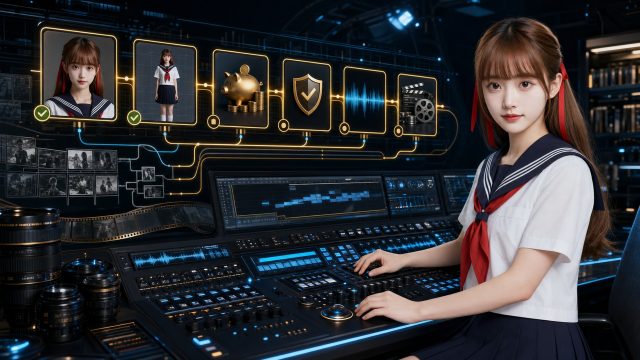
從第五集起,我把整個流程拆成十道關卡,前一關沒過,就不進下一關。
關卡的數量不是重點,重點是兩條規則:
- 改哪裡,就回到最早受影響的那一關。台詞錯了就回劇本關,後面已經通過的配音與剪輯,全部重新審。
- 機器檢查通過,不等於人工核准。程式可以確認檔案都在、尺寸正確、句數沒少;但臉對不對、這句話演得像不像,要人看、要人聽。
還有一個順序是刻意的:聲音比分鏡先鎖定。旁白實際唸多長,決定每張圖要停多久。先畫圖再配音,最後一定是在剪輯台上削足適履。
第一步:鎖住原典和敏感邊界
以第八集〈紅妝鬥氣〉為例,開工第一步不是寫劇本,而是把取材範圍鎖在第四十回與第四十一回,列出這兩回的六個關鍵事件,由我逐一核對。
同一份開工清單也先寫好敏感內容怎麼處理,例如:
- 角色扮成丫鬟的段落,維持成年的臉與身形。
- 丫鬟受罰不拍身體接觸,改用偏頭、茶盤落地與旁人反應來表現。
- 兩個角色受辱、受害的事都要清楚呈現,不能互相抵銷。
這一步看起來像在拖時間,其實是防兩件事:AI 用推論補上原文沒有的情節,以及生圖時才發現某個畫面根本不該這樣拍。
生圖指令我也寫成固定清單:畫風、角色基準圖、場景方位、一個看得懂的動作瞬間、構圖、道具數量、光線,再加一份排除清單。其中一條我到處沿用:中文字一律後製排版,不讓圖片模型寫字。模型寫的中文常是假字,一出錯整張圖就不能用。
「我有點看不懂」:最有價值的一句審核意見
第八集的第一版約 4 分鐘,技術檢查全部通過。我看完之後的審核意見是:
「建議字幕加上是誰說的話,其實這部我有點看不懂,很多畫面都沒有旁白,有沒有辦法加一些旁白來讓我覺得比較好懂或是比較精彩」
所有自動檢查都只能確認「東西都在」,沒有一項能回答「觀眾看不看得懂」。
AI 助手第一次補的旁白,寫成了一份解說稿。我沒讓它送出,只補了一個方向:旁白要跟前幾集同一種語氣,不要像在上課。它回去對照前兩集已發布的字幕,重寫成 14 段,用動作、物件與心事串起事件。
第二版變成 6 分 14 秒,每段字幕都標出是誰在說話,畫面也依每句配音的實際長度重新排。最後我還做了一個減法:拿掉全部配樂,只留旁白、對白與畫面,第九、第十集也照這個做法。
示意:下面兩句旁白是依本文原則寫的範例,不是成片台詞。同一件事:他等了一整晚的電話,最後沒有響。哪一句是「故事旁白」?
旁白 A(示意)
「這一段表現出他在對方心中並不重要,內心十分失落。」
這是故事旁白嗎?
點我看答案 ↻
這是解說稿
直接替觀眾下結論,像在上課。觀眾聽到的是評語,不是故事。
再點一次翻回去
旁白 B(示意)
「他把手機翻過來,又翻回去。十二點過了,螢幕一次也沒亮。」
這是故事旁白嗎?
點我看答案 ↻
這是故事旁白
用動作(翻手機)、物件(手機)和心事(等電話)串起事件,失落讓觀眾自己感覺到。
再點一次翻回去
讀音、道具與資料外傳,都要有人點頭
每張圖最多生成兩次。我曾在睡前請 AI 助手把能生的分鏡先生出來,醒來再一起審;一個晚上產出 47 張候選。範圍事先寫死:不花錢做影片、不上傳,每張最多兩次。有一張第二次沒有回傳,它沒有自己重送,而是保留第一版、把差異寫清楚交給我判斷。這條上限逼你停下來問:是指令寫錯,還是這個畫面本來就不該用生成的?
讀音要人耳確認。第二版我覺得有個詞唸起來怪怪的,請它重查。它逐句重查了文字讀音,但也照實寫明:當時的環境聽不到音訊,實際發音仍要人耳確認。這比一句「已全部校正」誠實得多。
道具照畫面寫,不照提示詞寫。有一張圖的指令要三顆木球,畫面只生出兩顆,紀錄就寫「實際兩顆」,再判斷影不影響劇情。包袱一開始用哪隻手提,後面出門的鏡頭也要沿用同一隻手。
資料外傳要先同意。免費的語音合成服務,代表每句台詞都要傳到外部。第八集補旁白時,第一次外傳先被自動審查擋下,等我明確同意才送;第九、第十集的新台詞,AI 助手也沒有沿用上一次的同意,而是再問一次。資料什麼時候離開你的電腦,應該是有人負責的決定。
完成後,我還用拉片工具回頭量了第八集的剪接點,46 刀全部對上剪輯時間軸;方法寫在拆解 AI 影片那一篇。成片在這裡:
所有人物影像、分鏡與語音都是 AI 生成,不是真人或實拍;成片已標註 AI 生成。
你可以這樣開始
- 先判斷畫面需不需要真的動。以對白與心事為主的故事,先試「靜態圖+旁白+有理由的運鏡」。
- 開工前寫一頁取材清單:用哪幾章、關鍵事件有哪些、敏感內容怎麼拍。
- 先錄好旁白再畫分鏡,讓聲音決定每張圖停多久。
- 每張圖設生成上限,例如兩次;第二次還不行,就回頭檢查指令或換畫面。
- 第一版給沒讀過原著的人看,問他一句:「哪裡看不懂?」