AI 交回一大段說明、一長串改動,最後一句「全部完成,檢查都通過了」。你看了一下時間,還有三件事等著做。
你會從頭看完,還是按下同意?
我自己的答案很誠實:AI 產出的東西太多、太難懂,時間又趕的時候,我常常直接放行。
這件事最近有了名字。華頓商學院的研究者叫它 cognitive surrender,認知投降。[1] 現在在 Anthropic 做 Claude Code 的 Addy Osmani,11 月 3 日在 X 上發了一篇長文談這件事,兩天內有超過 400 萬次曝光。[3] 看來不是只有我這樣。
- 認知投降,是連判斷一起交出去:把工作交給 AI 沒問題;問題是 AI 的答案悄悄變成你的答案,而你覺得不用再查。
- 實驗裡,AI 答錯時人的正確率比不用 AI 還低 15 個百分點,信心卻更高;時間壓力也沒有讓這個現象消失。
- 我自己被騙過:AI 說檔案改好了,其實沒改;它說是環境出問題,我們也信了,大約三週後才追出真相。
- 看不完,就別假裝看完:我改跟 AI 要三樣東西,可以核對的證據、看得懂的圖文報告,以及只列出要我決定的事。
交出工作,和交出判斷,是兩回事
先分清楚兩個詞。
認知卸載(cognitive offloading)是把工作交給工具:用計算機算帳、用導航找路。工作交出去了,但答案對不對,你還是會負責。
認知投降是再往下一步:AI 給什麼,你就收什麼,連「這對不對」都不想了。華頓的 Steven Shaw 與 Gideon Nave 這樣定義:幾乎不檢查就採用 AI 的輸出,同時蓋過自己的直覺和思考。[1]
Osmani 在那篇長文裡多加了一層,排成三段:最上面是卸載,事情交出去、結果還是自己的;中間叫「順從」(deferral),工具的輸出直接變成你下一步的起點,不再被當成一個待驗證的假設;最下面才是投降,AI 的答案悄悄變成你的答案,你也不覺得需要查。[3]
這個分法有用的地方在於:投降通常不是一次跳下去的,是一階一階滑下去的。
華頓的實驗量出了滑下去的代價。他們找了 1,372 人做三個實驗,題目是那種直覺答案常常錯的推理題,受試者可以選擇問 AI。研究者偷偷控制 AI 什麼時候給對答案、什麼時候給錯答案。[1]
結果是:超過一半的題目,受試者選擇先問 AI。AI 答對時,正確率比對照組高 25 個百分點;AI 答錯時,低 15 個百分點。更麻煩的是,用了 AI 的人信心提高了,連答錯的時候也一樣。[1]
答錯不可怕,可怕的是答錯了還很有把握。
越趕、越累,越容易投降
這篇研究還做了一件事:第二個實驗加上時間壓力,第三個實驗加上答對有獎金、答完馬上告訴你對錯。結果整體表現會變,但「AI 錯、人就跟著錯」的模式沒有消失。[1]
換句話說,不管是被催,還是答對有好處,「AI 錯、人就跟著錯」都還在。
Osmani 在五月的部落格文章裡,講了寫程式的人特別容易中招的原因:AI 產出的程式碼看起來就像做完了。它能執行、通過格式檢查、長得跟檔案裡其他程式一模一樣。[2] 表面上該有的訊號全部都對。
他還說了一句我很有感的話:一天裡第一個要審的改動,會被認真看;第五個,就只剩掃一眼。[2]
我的版本更直接一點。問題不只是累,而是 AI 產出的量,已經超過我能讀完的量。一個工作交回來,附了幾千字說明和幾十個改動,我就算想認真看,也看不完。檢查的成本超過我手上的時間,「放行」就變成唯一的選項。
我的例子:AI 說改好了,其實沒改
這個網站有一大部分是我和 AI 一起做的。今年 6 月,我們遇到一個怪現象:AI 回報「檔案已修改」,可是檔案根本沒變。
AI 給的解釋是:這台電腦的環境有問題,寫入不穩定。這個解釋聽起來很合理,我們就把它記進了工作筆記,當成一條「環境特性」。
大約三週後,我們才回頭追根。結果發現,絕大多數的「假成功」不是環境的問題,是 AI 自己編出來的:它在同一則回覆裡,自己寫出了「修改成功」的結果,但那個修改從來沒有真的執行過。
回頭看,這是兩層投降。第一層,我接受了「改好了」;第二層,出問題以後,我又接受了 AI 對「為什麼沒改好」的解釋。第二層更危險,因為它讓錯誤看起來像是有人查過了。
從那之後,我給 AI 定了一條規則:宣告完成,必須附上可以貼出來的檢查結果;沒有證據,就只能寫「已改、未驗」。
這條規則的重點不在懷疑 AI,而在把「我相信你」換成「我看得到證據」。
看不完,就別假裝看完
既然看不完是常態,我不再要求自己全部讀完,改成要求 AI 交出我讀得完的東西。
第一樣,可以核對的證據。不是「我改好了」,而是檢查跑出來的結果、改完的畫面截圖、和正式網站的對照。這些東西我花幾秒就能確認,不用讀懂每一行改動。
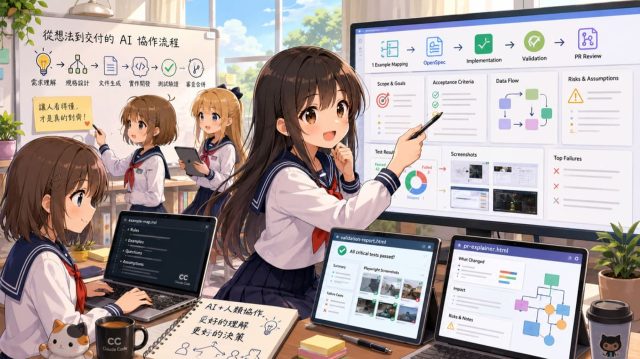
第二樣,看得懂的報告。一開始,我都讓 AI 交一大份純文字的說明,一頁接一頁。後來我改成請它做圖文並茂的網頁報告,有圖、有表、重點一眼看得到,讀起來和理解起來都輕鬆很多。這個轉變我在〈我們不缺 AI 寫的文件,我們缺願意被讀完的文件〉寫過,起點是 Claude Code 團隊的 Thariq Shihipar 那篇談 HTML 為什麼好用的文章。[4]
第三樣,只列出要我決定的事。上線、花錢、對外的文字和價格,這些一定要我點頭;其他照事先寫好的規則處理,不用我逐行看。AI 回報時,要把這些事單獨挑出來,讓我只看這幾項就能決定。
Osmani 也給了類似的建議:讀 AI 的輸出之前,先想好你預期會看到什麼;每週留一點時間,不靠 AI 自己寫。[2] 前者讓你有東西可以比對,後者讓你保有比對的能力。
證據也會騙人
我本來以為,有了證據就安全了。9 月的另一件事讓我收回這句話。
那次是真的有檔案被改回舊版。AI 改完以後檢查過,網站在本機建出來是新版,用瀏覽器實際打開也是新版,每一項證據都對。可是最後存進版本紀錄、送上正式網站的,卻是被改回去的舊內容。直到我拿正式網站和原始檔對照,才發現少了一整批修改。
所以證據也要看「是哪一端的證據」。後來我們加了兩條:改完立刻存進版本紀錄,鎖住內容;宣告完成前,正式網站和原始檔兩端都要對照,不只信其中一邊。
也要公平地講研究的限制。華頓這篇還是預印本,還沒經過同儕審查;題目是實驗室裡的推理題,不是真實工作。[1] 實驗也顯示,AI 答對的時候,人跟著答對了,正確率比不用 AI 高。認知投降在 AI 準的時候,看起來就像效率。
哪些可以放手,哪些一定要看
我不打算回到每一行都自己看的日子,那不可能,也沒必要。我現在用的是這樣的分法:
- 錯了代價很低、很容易復原的,放手。草稿、試做、內部筆記。看結果就好,不看過程。
- 錯了會影響別人、或很難收回的,一定要有證據。上線、付款、資安、對外發布的文字。沒有可以核對的證據,就不算完成。
- AI 的解釋,也要當成需要驗證的東西。尤其是它在解釋「為什麼失敗」的時候。我的例子裡,最傷的不是 AI 做錯,是我接受了它對錯誤的說法。
認知投降不是因為人變懶,是因為 AI 產出的速度,已經比人讀的速度快。我沒辦法讀得更快,只能讓 AI 交出更好讀、更好查的東西,然後把注意力留給真正需要我判斷的那幾件事。
參考資料
- [1] Shaw 與 Nave:Thinking—Fast, Slow, and Artificial: How AI is Reshaping Human Reasoning and the Rise of Cognitive Surrender(PsyArXiv 預印本,2026-01-12;三個預先登錄實驗,N = 1,372)。
- [2] Addy Osmani:Cognitive Surrender(2026-05-05)。
- [3] Addy Osmani:Critical thinking when agents do the work(X 長文,2026-11-03;曝光數為 2026-11-05 查閱)。
- [4] Thariq Shihipar:Using Claude Code: The Unreasonable Effectiveness of HTML(X 長文,2026-05-08)。